支持向量机(Support Vector Machine,SVM)是一种经典的二分类算法,主要用于分类任务,也可以用于回归和异常检测。在深度学习兴起之前,广泛应用于文本、图像相关的任务场景。虽然如今深度学习已经成为主流,但 SVM 并没有彻底退出舞台,在不少传统任务场景下仍有不错的实用性,依然是机器学习学习者需要掌握的经典理论。
本节课,我们不讲解复杂的数学公式,只从算法的外围建立对算法的初步认知和理解。
1. 核心公式
支持向量机的核心是决策函数,也是模型完成分类预测的核心依据。公式如下:
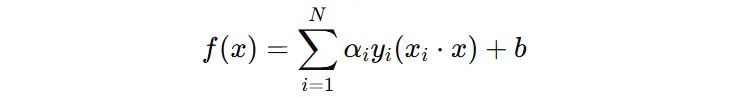
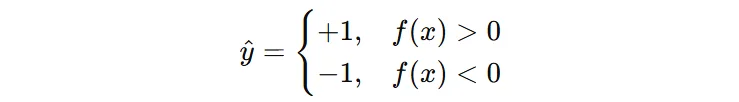
初步理解一:支持向量根据 \(f(x)\) 的符号来确定预测类别,\(f(x) > 0\) 归类为 \(+1\) 类别,\(f(x) < 0\) 归类为 \(-1 \) 类别,\(f(x) = 0\) ,通常人为规定将其划分到某一类别。注意:有些二分类算法使用 0 和 1 表示两个类别,支持向量机使用 +1 和 -1 表示两个类别。
- \(x_{i}\):训练过程中最终确定的,对分类结果起决定作用的关键样本。
- \(y_{i}\):训练过程确定的关键样本的标签
- \(\alpha_{i}\) 训练过程确定的关键样本对分类结果的影响程度
初步理解二:支持向量机训练过程就是在寻找少量的关键样本,预测结果由这些关键样本决定,注意:绝大多数普通样本虽然参与训练,但不参与最终模型决策。这些关键样本也叫做支持向量,这也是算法名字的由来。
假设,经过训练我们得到 b = -1,关键样本如下:
| 支持向量 | 特征 | 标签 y | α值 |
|---|---|---|---|
| SV1 | (2,3) | +1 | 0.5 |
| SV2 | (1,1) | -1 | 0.3 |
| SV3 | (3,1) | +1 | 0.8 |
现在来了一个新样本 (2, 2),我们进行预测:
- 第一个支持向量:\(0.5 · 1 · (2,3) · (2,2) = 5\)
- 第二个支持向量:\(0.3 · -1 · (1,1) · (2,2) = -1.2\)
- 第三个支持向量:\(0.8 · 1 · (3,1) · (2,2) = 6.4\)
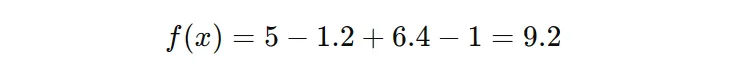
由于 9.2 大于 0,新样本归类为 +1 类别。
2. 抛出问题
我们前面已经知道,支持向量机最终得到的决策函数,只与支持向量有关。接下来,我们将支持向量对模型的影响合并到权重向量中,定义:
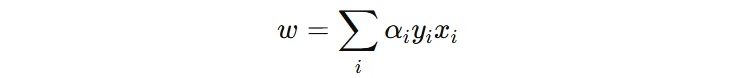
将上面的权重向量 \(w\) 代入决策函数,可以将原来的决策函数统一写成:
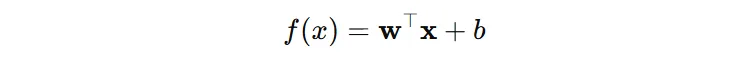
这个函数是一个线性分类函数:
- 在 \(f(x)>0\) 一侧,样本为 +1 类别。
- 在 \(f(x)<0\) 一侧,样本为 -1 类别。
- \(f(x)=0\) 是两个类别的边界位置,在二维空间中,它是一条直线。在三维空间中,它是一个平面。在更高维空间中,则称为超平面。
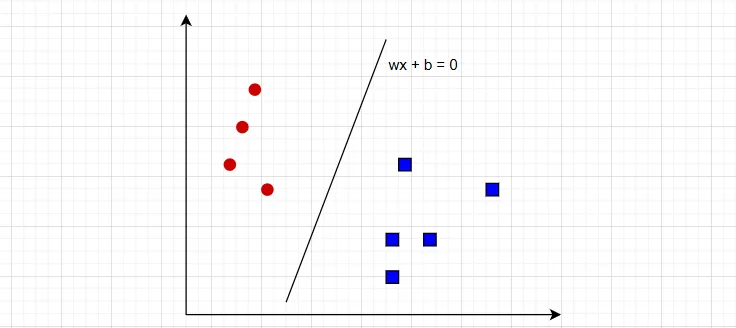
初步理解三:支持向量机是一个线性分类模型,它通过寻找一个分类超平面,将两个类别的样本分开。注意:\(f(x)\) 叫做分类函数,\(f(x)=0\) 叫做分类超平面。
思考:到这里我们会发现一个问题:能够将两个类别样本分开的超平面通常不止一个。那么,支持向量机为什么选择这个超平面,而不是另外一个?它选择超平面的依据是什么?