上一节我们从抗扰动的角度,推导出 SVM 的初始形式。该形式不适合直接求解,接下来我们会对目标函数及其约束条件做转换与改造,将它转化为更常用的标准形式。
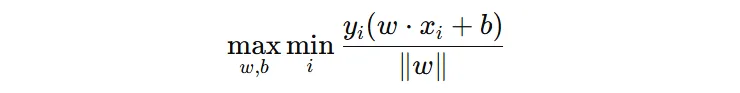
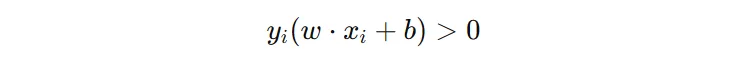
1. 简化目标
在初始形式的目标函数中,们要最大化离超平面最近样本的几何间隔。下面看这个式子如何简化。
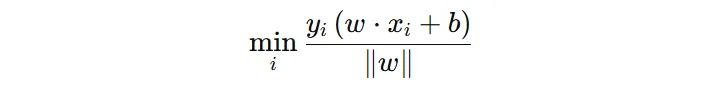
先明确关于 \((w,b)\) 缩放的三个不变性质:
1️⃣ 我们缩放 \(w\) 与 \(b\) M 倍时,样本到超平面的几何间隔不变。
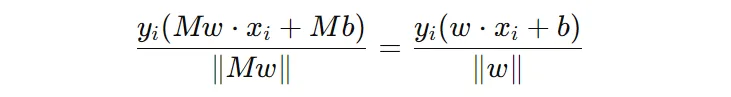
2️⃣ 我们缩放 \(w\) 与 \(b\) M 倍时,超平面不会变化。
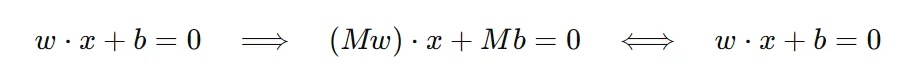
3️⃣ 我们缩放 \(w\) 与 \(b\) M 倍时,函数间隔会缩放 M 倍。
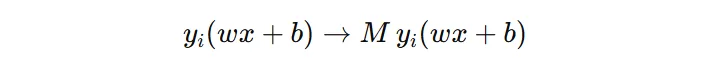
利用这三条性质,我们可以在不改变优化问题含义的前提下,挑选一个合适的缩放系数 \(k\) 对 \((w, b)\) 进行缩放,使得最小的函数间隔为 1:
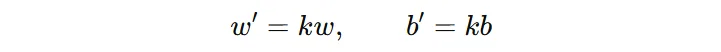
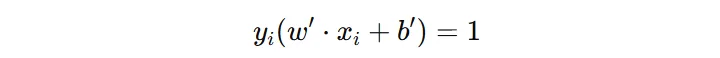
这里有个关键点:原来的最小函数间隔大于 0,可以是 0.2、0.5 或者别的正数,我们都可以缩放参数,强制让最小函数间隔变成 1,并且不会影响超平面的位置,也不会影响样本到超平面的几何距离。
那么,样本到超平面的最小几何距离表示简化为:
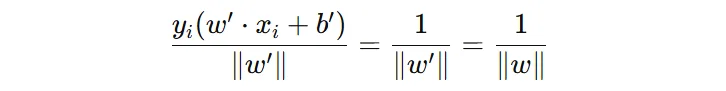
至此,我们的目标函数变成下面这种形式(注意:这个目标函数还要满足约束条件):
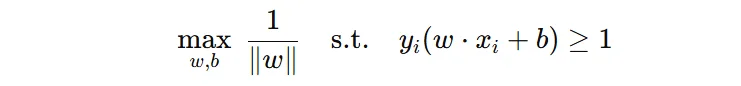
最大化问题转换为最小化问题:
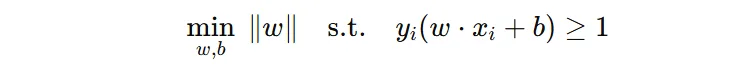
\(||w||\) 带根号不好求导,平方去掉根号,\(1/2\)用来后续求导消去系数,最优解不变为。目标函数写成:
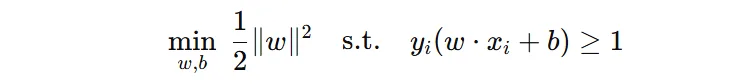
目标函数的含义是:希望找到一个分类超平面,使所有样本不仅能够被正确分类,而且距离超平面最近的样本也尽可能远,从而让分类边界具有更强的抗扰动能力。
2. 约束松绑
支持向量机的目标函数,要求所有的样本在满足约束 \( y_{i}(w·x_{i} + b) \ge 1 \) 的前提下,寻找最小几何间隔最大的超平面。但现实中,数据往往存在噪声、异常点,甚至可能线性不可分,导致部分样本无法满足这个严格约束,使得支持向量机不存在可行解。
为解决这一问题,需要对约束条件进行松绑,允许部分样本违反 \( y_{i}(w·x_{i} + b) \ge 1 \) 约束,但同时,我们也不能无限制的允许样本违反约束。
具体做法是,在目标函数中引入一个非负松弛变量 \(\xi\),该变量用于记录每个样本违反约束的程度。
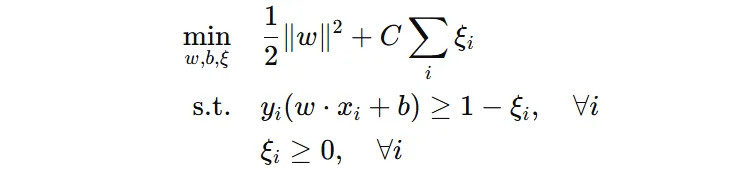
假如:\(\xi = 0.3\) 表示该样本没有完全满足间隔约束,而是违反了 (0.3) 程度的要求。这个违反约束的程度会通过松弛变量 \(\xi\) 体现到目标函数中。
公式中,第一项是分类间隔,第二项是训练误差,惩罚参数 C 是用于在两者之间进行权衡的重要参数。
- 当 C 较小时,模型认为部分样本违反间隔约束是可以接受的,因此会更加关注获得更大的分类间隔,对噪声和异常样本不敏感,具有更好的泛化能力和抗扰动能力,但可能产生较多训练误差。
- 当 C 较大时,模型更加重视减少违反约束,会尽可能让训练样本满足间隔约束,即使需要牺牲部分分类间隔。但如果过度关注训练样本,模型可能会受到噪声和异常点影响,导致泛化能力下降。
3. 合页损失
前面我们引入松弛变量,放宽了硬间隔约束,得到了新的优化目标。但是这种带约束的优化形式不方便直接求解,我们可以利用松弛变量的定义,将约束条件融合进目标函数,等价改写为无约束的目标函数形式。
我们从损失函数的角度,来理解样本的间隔违例:
- 当样本满足 \( y_{i}(w·x_{i} + b) \ge 1 \),分类正确,损失为 0
- 当样本满足 \( 0 < y_{i}(w·x_{i} + b) \lt 1 \),分类正确,在间隔内部,损失为 (0, 1)
- 当样本满足 \( y_{i}(w·x_{i} + b) = 0 \),样本落在边界上,损失为 1
- 当样本满足 \( y_{i}(w·x_{i} + b) \lt 0 \),损失为大于 1
我们按照这个思路,将约束条件转化为下面的样本损失,这个损失就是合页损失(hing loss)。
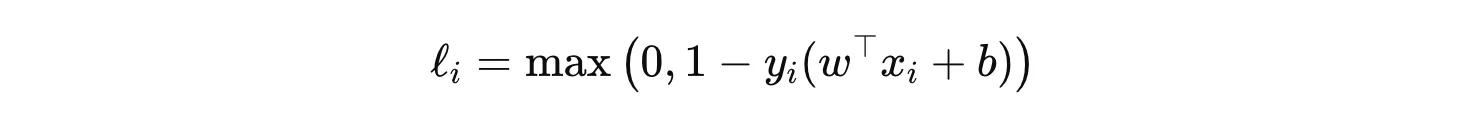
现在,我们得到了一个不包含约束条件的目标函数:
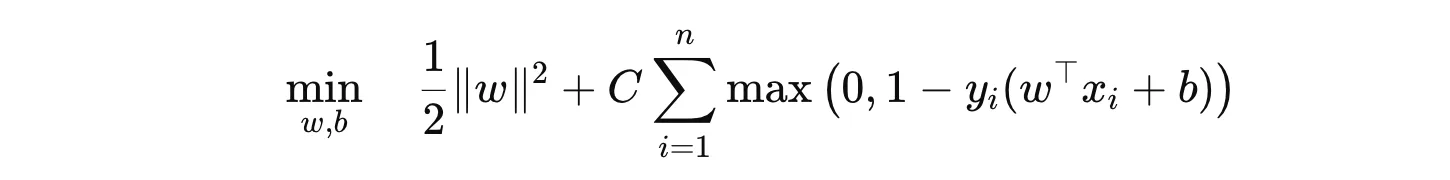
注意:当我们转换为上面这种形式后,我们就要换种理解了,前者是正则化项,对权重进行约束。后者是合页损失项,衡量间隔违例的代价。
上面我们推导的是标准合页损失。在 scikit-learn 的 LinearSVC 中,默认使用的并不是标准合页损失,而是平方合页损失,把合页损失的结果再做一次平方。
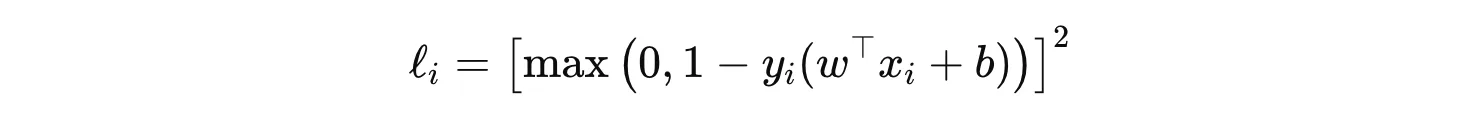
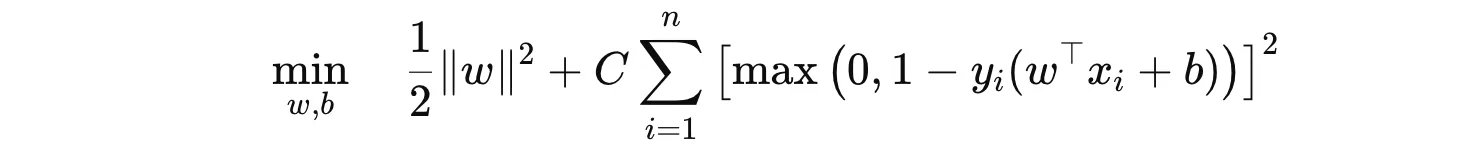
标准合页损失对间隔违例样本是线性惩罚,平方合页损失是二次惩罚,样本偏离间隔越远,惩罚上涨得越快。
注意:平方合页损失不再等价于我们最开始带松弛变量 \(\xi_{i}\) 的软间隔 SVM 原问题。
在 LinearSVC 中,还有一个非常重要的参数 penalty,它用来选择损失函数的正则化项,主要有 L1 和 L2 两种,两者的作用都是防止权重参数过大。因为权重过大,决策函数对某些特征的变化就越敏感。
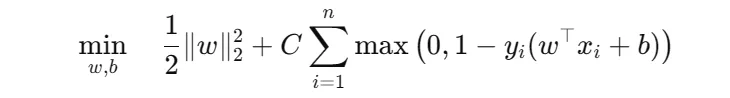
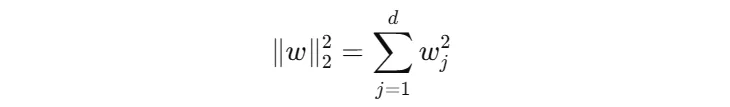
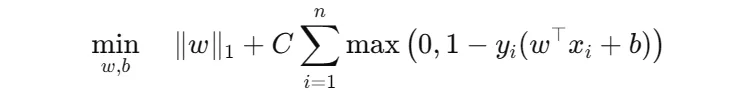
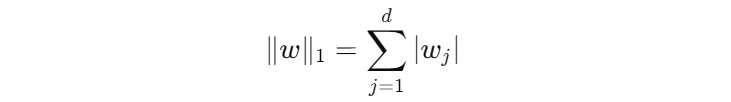
- L1 正则化:惩罚权重的绝对值之和,倾向于让部分权重变为 0,从而实现特征选择。
- L2 正则化:惩罚权重的平方和,倾向于让权重整体变小,尤其会对较大的权重施加更强的惩罚。
LinearSVC 还有另外一个重要的参数 dual,当设置为 False 时,求解原始问题。当设置为 True 时,求解对偶问题。原始问题主要围绕权重 (w) 展开,待求变量的数量与特征维度有关。而对偶问题的待求变量与训练样本数量有关。
当特征维度很高、训练样本数量相对较少时,求解对偶问题通常更有优势。反过来,当训练样本数量远大于特征维度时,求解原始问题通常更合适。
除此之外,如果想要引入核技巧,通常需要通过对偶问题来实现。因为对偶问题可以将核函数引入目标函数,从而实现非线性分类。