前面我们抛出了一个问题:支持向量机就是寻找一个超平面,把两个类别的样本分开。但是,能够将两个类别样本分开的超平面有很多个,那么支持向量机应该如何选择其中最优的那个?选择依据是什么?接下来,我们从支持向量机的设计思想出发,理解它选择最优超平面的核心原则。
1. 最大间隔
在模型训练时,我们通常会选择质量较高的训练数据,让模型从中学习规律。但在实际应用中,输入数据可能受到噪声或测量误差的影响,与训练时的数据存在一定差异。
那么,这种数据差异会带来什么问题呢?
假设训练时,某个属于 +1 类的样本是 \((2.1, 3.5, 1.8)\),而在实际预测时,由于噪声或测量误差,输入数据变成了 \((2.08, 3.52, 1.81)\)。虽然数据只发生了微小变化,就可能导致模型将它错误地分类为 −1 类。
因此,我们希望模型不仅能够正确分类训练样本,还能在输入数据发生一定程度的变化时,尽可能保持分类正确。
那么,怎样才能让模型面对输入数据的微小变化时,仍然尽可能保持分类正确呢?
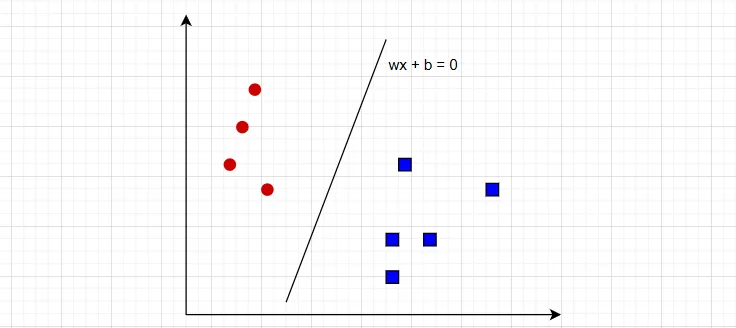
一个直观的思路是:让分类边界尽可能远离样本。 因为样本距离分类边界越近,受到微小扰动时,就越容易跨越边界,导致分类结果发生变化;反之,样本距离分类边界越远,就越不容易因为微小扰动而被错分。
注意:训练数据中有很多样本,它们到分类边界的距离并不相同。有些样本距离边界很远,有些样本却紧贴边界。对于距离边界很远的样本,即使发生一定程度的扰动,通常也不容易被错分。真正值得我们关注的,是那些距离边界最近的样本,因为它们最容易受到扰动的影响。
因此,支持向量机的思路是:关注训练样本与分类边界之间的距离,尤其是距离分类边界最近的样本,并尽可能增大这些样本与边界之间的距离,这就是最大间隔思想。
2. 公式落地
以上从扰动的角度,理解最大间隔的设计动机。下面我们把这个思路转化为数学表达式,完成公式落地。
假设:样本 \(i\) 可能受到的扰动为 \(\delta_{i}\),上限为 \(\epsilon_{i}\):
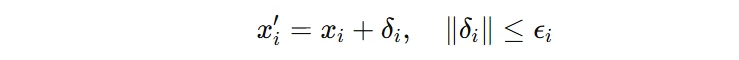
注意:\(||\delta_{i}|| \lt \epsilon_{i}\)表示样本最大允许偏离原位置的距离。
对于线性分类器 \(f(x)=w·x+b\) 分类正确条件为:
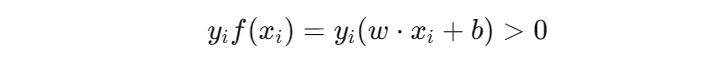
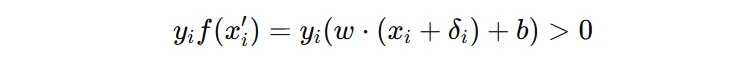
展开后可得:
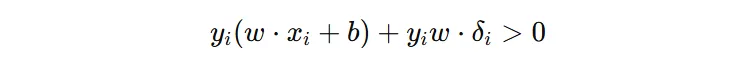
第二项是扰动带来的影响,当第二项负向影响足够大的时候,就可能会改变符号,从而改变最终的分类结果。我们希望在受到扰动的时候,仍然能够分类正确,就需要进一步分析第二项,了解它的最坏情况下是什么样的。
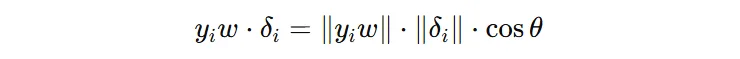
我们发现,当 \(\theta\) 为 π 时,\(\delta_{i}\) 达到扰动的上限。
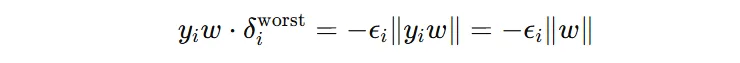
注意:\(||y_{i}w||\) = \( |y_{i}| ||w||\) = \(||w||\)
把最坏扰动代回原始条件:
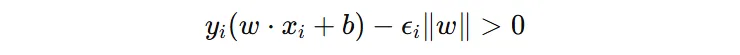
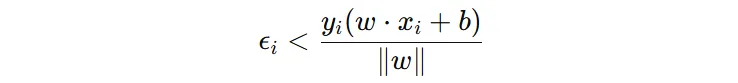
- 左边:扰动上限
- 右边:样本到超平面的几何距离
此时,我们就得到了最大扰动和样本到超平面距离的关系公式。超平面距离样本越远,模型对输入扰动的容忍能力越强。而距离越近,样本受到微小扰动时,就越容易跨越分类边界,导致分类结果发生变化。
我们前面提到:
关注训练样本与分类边界之间的距离,尤其是距离分类边界最近的样本,并尽可能增大这些样本与边界之间的距离。
所以,支持向量机优化目标可表示为:
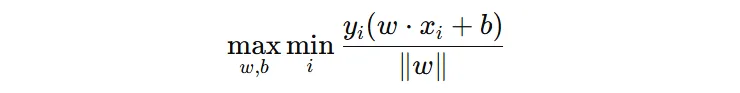
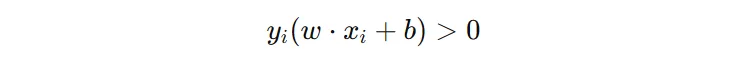
公式含义为:内层 min 求所有样本里距离当前超平面的最短几何间隔。外层 max 搜索超平面参数,使得这个最短距离尽可能大。