上一节,我们把 SVM 的原始优化问题写成了合页损失的形式,同时也说到了它存在一个明显局限:当特征维度很高、训练样本数量相对有限时,原问题的优化变量是权重\(\boldsymbol w\),它的维度和特征维度保持一致,直接求解的计算压力会非常大。
那该怎么缓解这个问题?前面我们铺垫过一个解决思路:不必直接求解原问题,可以先将原问题转化为对偶问题再进行求解。转换成对偶形式之后,待优化参数的数量就等于样本数量。这样一来,在样本少、特征维度很高的场景下,我们需要求解的参数更少,计算负担自然也就更小。
那对偶问题到底该怎么理解?简单来说:原问题是站在权重\(\boldsymbol w\)的角度做优化;对偶问题相当于我们换一套变量、换一个视角,来处理同一个优化目标。二者切入问题的角度不同,但是最后我们能得到一样的最优结果。
既然对偶问题有这样的优势,我们要如何从原始优化问题,一步步推导出对应的对偶问题呢?整个推导过程依赖的核心工具,就是 KKT 条件。
如果一上来就把 KKT 条件套进 SVM 复杂的公式里,概念会很抽象,大家不容易跟上。所以我们先暂时放下 SVM,从一个简单的带约束优化小例子入手,带着大家完整走一遍流程,看一看如何借助 KKT 条件,完成从原问题到对偶问题的转换。
1. KKT 条件
在很多优化问题中,我们希望找到一个变量,使目标函数最小,但是变量需要满足一些限制。比如下面的例子:
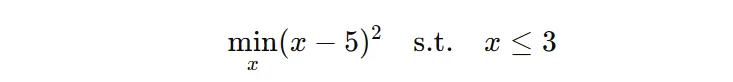
我们先直接看这个问题,如果没有约束,只需要求导令其等于 0,就可以求得 x=5。但是加入约束以后,就不能这么简单求解,因为要需要同时考虑:目标函数、约束条件。那我们应该怎么求解?将原问题转换为对偶问题,间接求解原问题。
注意:这个问题本身非常简单,无需转换对偶,我们这里只是通过简单例子更好理解如何获得对偶问题。
将原问题转换为对偶问题的步骤是:
- 首先,使用拉格朗日乘子法,将目标函数和约束条件组合到一起,构造拉格朗日函数。
- 然后,利用 KKT 条件刻画原问题的最优解,并通过驻点条件消去原问题中的变量,得到对偶问题。
- 最后,求解对偶问题,再反推出原问题的最优解。
1.1 构造拉格朗日函数
第一步:使用拉格朗日乘子法,将目标函数和约束条件组合到一起,构造拉格朗日函数。
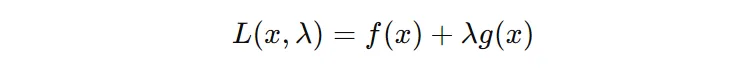
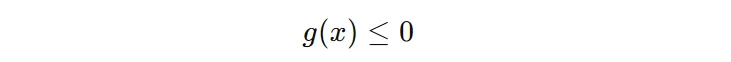
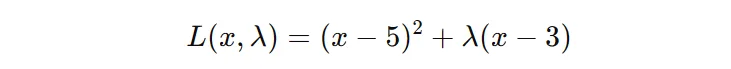
\(\lambda\) 称为拉格朗日乘子。到这里,重点注意下,原来是 min 问题,变换成拉格朗日函数后,变成了 min max 问题,如下公式所示:
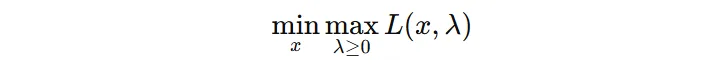
原问题是带约束的优化问题。在搜索变量 x 时,我们需要额外校验 x 是否满足约束,不满足的解直接舍弃。转化为拉格朗日函数之后,这套约束校验逻辑,就交由内层的 max 来完成。接下来,我们来看看 max 如何使得约束条件工作。
为了更加便于理解,我们假设所有候选的 x 都放在一个筐子里,整个优化过程,就是从筐子里取出来所有候选的 x,找到 \(L(x, \lambda)\) 最小时对应的 x 解。但是要注意,筐子里的 x 有些满足约束条件,有的不满足约束条件,我们得在寻找最优解的时候,把不满足约束条件的 x 踢出去。接下来,我们就看看内层的 max 如何将不满足约束条件的 x 踢出去的?
| 候选解 | \((x-5)^2\) | \(\lambda(x-3)\) | max | 含义 |
|---|---|---|---|---|
| x=2 | 9 | -1 * λ | 为了取最大值,令 \(\lambda=0\),第二项为 0 | 满足约束条件 \(x\leq 3\),不受到惩罚 |
| x=5 | 0 | 2 * λ | 为了取最大值,令 \(\lambda\to+\infty\),整个函数趋于无穷大 | 违反约束条件,受到无限大的惩罚,该解会被排除 |
| x=3 | 4 | 0 | 无论 \(\lambda\) 取什么值,第二项始终为 0 | 恰好满足约束边界,不受到惩罚 |
内层的 max 实现了约束的自动校验。\(\lambda\) 是拉格朗日乘子,它会跟随候选 x 自动调整大小,对违反约束的解施加惩罚。
我们要找的是 \(\min_x \max_\lambda L(x,\lambda)\) 的解,需要先对内层关于 \( \lambda\) 取极大,再对外层关于 x 取极小。
1.2 最优解的必要条件
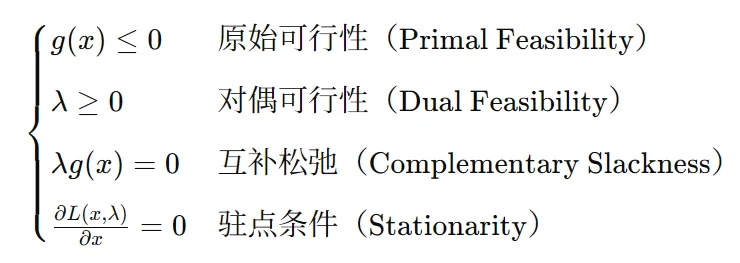
给定任意一个候选 x,内层 max 会对它做筛选。能够通过筛选的 x,需要遵守下面三条规则:
- \(x <= 3\),这是我们原始的约束条件。
- \(\lambda >= 0\),如果允许 \(\lambda\) 是负数,整个惩罚逻辑就失效了。
- \(\lambda \cdot (x-3) = 0\), \(\lambda\) = 0,或者 \( (x-3) = 0\) 。
但这里还有一个问题:通过内层的 max,我们只是找到了满足约束对应的 λ,但是并不知道哪个 x 才能让 \(\max_\lambda L\) 整体最小?
接下来,我们把 λ 代入,拉格朗日函数就变成只关于 x 的函数,这就变成普通无约束求极小问题,直接对 x 求导,就能算出这一组候选对应的函数值。
对内层 (\max) 我们得到三条约束规则,而对 x 求极小要求导数为 0,也就是驻点条件。把这几部分合在一起,就是 KKT 条件。
KKT 条件,是带有不等式约束的优化问题最优解的必要条件。只要是最优解,就一定满足这一套条件。但满足这套条件的解,不一定就是最优解。在凸优化问题里,它同时也是充分条件,满足 KKT 的点,就一定是最优解。
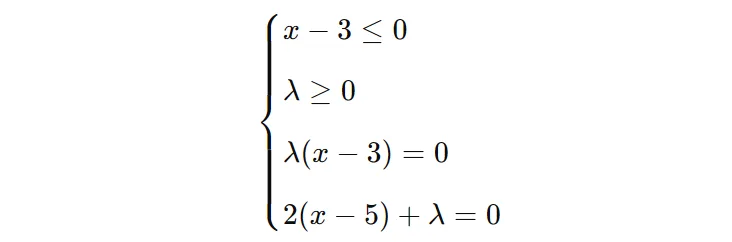
1.3 对偶问题推导求解
接下来,我们利用第 4 点驻点条件,将原始关于 \(x\) 的问题,转换为关于 \(\lambda\) 的问题,这就是原问题的对偶问题,知道了 \(\lambda\) 就可以求出 \(x\) 。
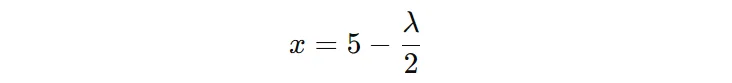
我们将 \(x\) 代入到拉格朗日函数中,得到关于 \(\lambda\) 的函数,这就是原问题的对偶问题。数学上的对偶,是指一个优化问题可以转换为另一个与之对应的优化问题。两个问题描述的是同一个优化目标,但它们关注的变量和求解视角不同。
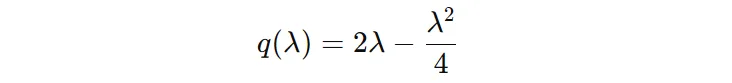
第三步:求解对偶问题,再反推出原问题的最优解。
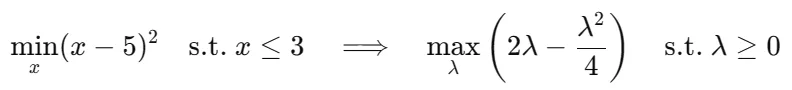
接下来,对 \(\lambda\) 求导令其等于 0,得到 \(\lambda = 4\),由此得到 \(x = 3\)。
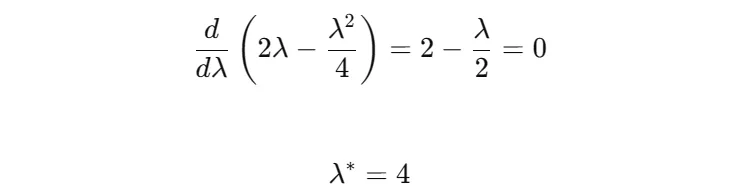
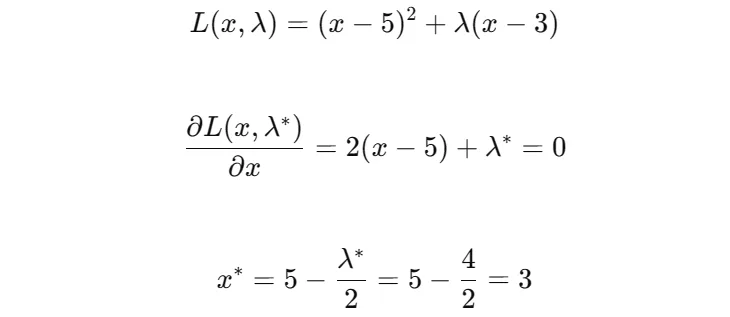
最后,将计算结果代入 KKT 条件中,全部满足。
2. SVM 对偶
支持向量机目标函数形式和前面的简单例子类似,只不过稍微复杂一些。我们仍然可以套用前面的解题思路。
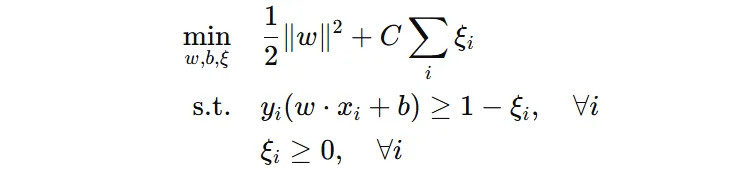
第一步:使用拉格朗日乘子法,将目标函数和约束条件组合到一起,构造拉格朗日函数。
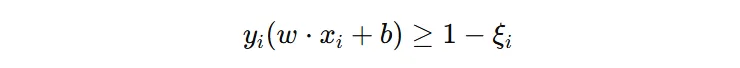
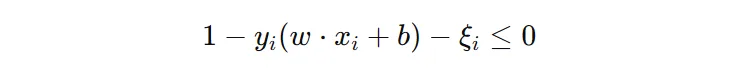
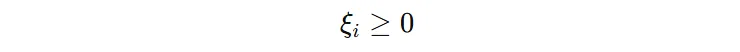
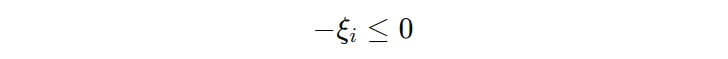
接下来,我们增加将目标和约束合成一个拉格朗日函数,把带约束的最小化问题,变成一个无约束的问题:
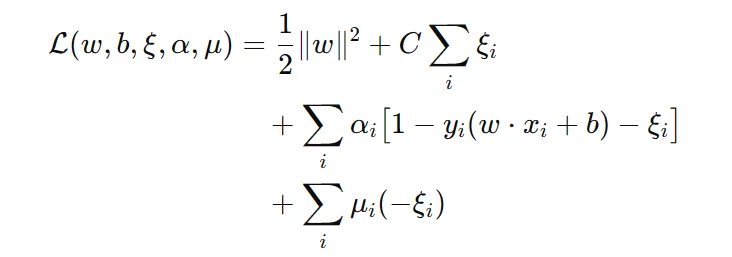
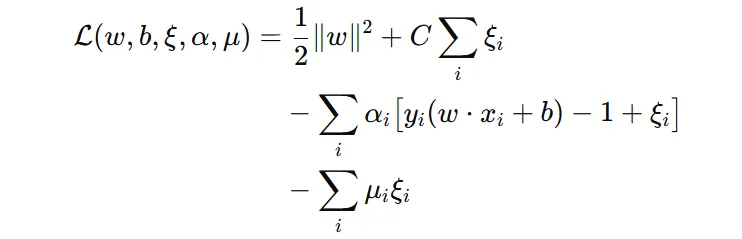
原来优化的是 min 问题,现在则变成一个 min–max 问题。虽然这里公式复杂了一些,但是和前面讲解的简单例子思路是类似的,内部的 max 用来为候选的解施加约束条件。
但是这里注意:\(\alpha_i\) 会有一个上限,不会无限大,这是由 KKT 条件中的驻点条件限制的。
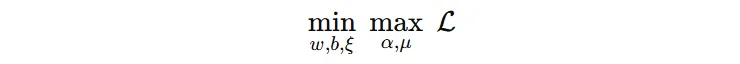
第二步:利用 KKT 条件刻画原问题的最优解,并通过驻点条件消去原问题中的变量,得到对偶问题。
原问题是一个关于 \(w、b、\xi\) 的优化问题,我们现在使用 KKT 条件将问题转换为对偶问题,即:求解 \(\alpha_{i}\),从而求解出 \(w、b、\xi\) 。
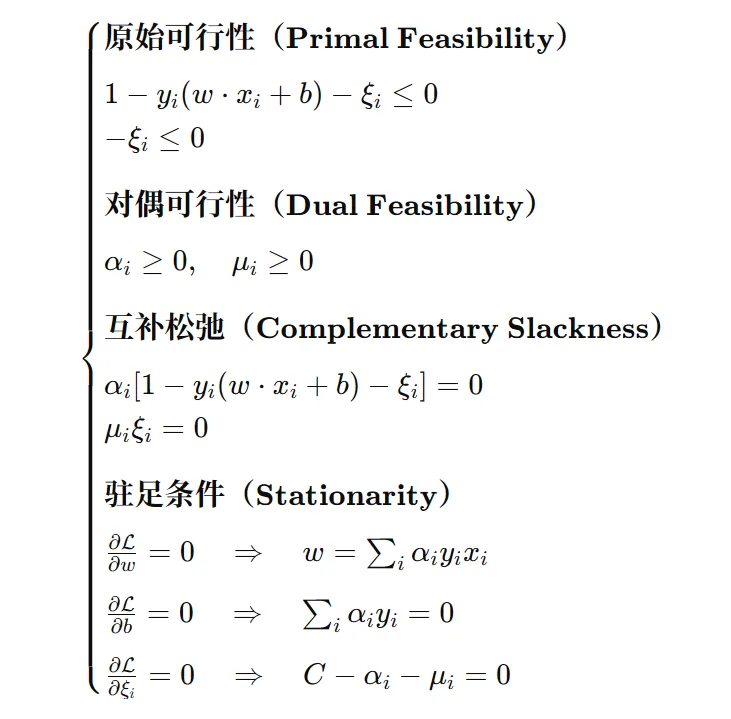
这里有个注意点,根据驻点条件可以得到下面的公式:
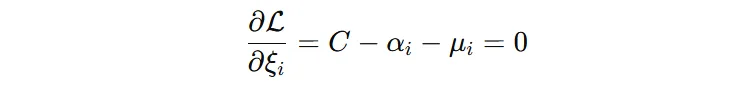
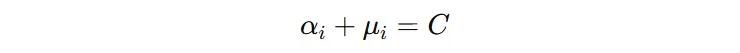
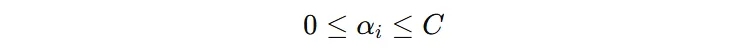
接下来,我们利用 KKT 条件的驻足条件,消去 \(w、b、\xi\),得到只与 \(\alpha\) 有关的问题:
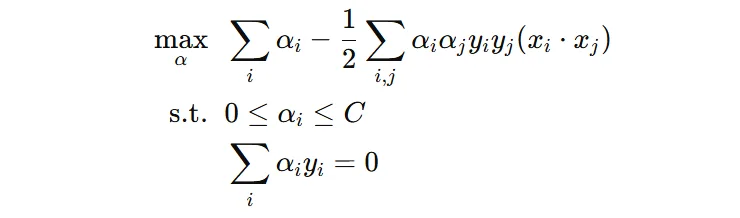
第三步:求解对偶问题,再根据 KKT 条件反推出原问题的最优解。
我们通过求解每个样本对应的拉格朗日乘子 \(\alpha_{i}\),可以进一步得到超平面的关键参数 \(w\) 和 \(b\)。支持向量机的优化问题属于凸优化问题,理论上存在全局最优解。
简单例子只需要求解单个变量 \(\lambda\),直接求导就能得到最优解。SVM 对偶问题有 \(\alpha_1,\alpha_2,\dots,\alpha_n\) 一大堆变量,变量之间通过交叉项 \(\alpha_i\alpha_j\) 互相耦合,再加上全局等式约束 \(\sum \alpha_i y_i=0\),无法直接一次性求出全部变量的解。
因此,实际求解的难点在于如何高效计算,实际中通常采用序列最小优化(SMO)等算法。我们这里就不介绍 SMO 算法了,假设求解之后得到每个样本对应的 \(\alpha_{i}\),我们就可以得到决策函数。
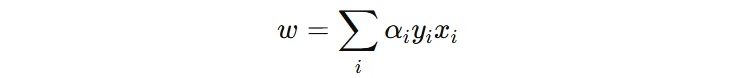
找一个 \(0 < \alpha_{i} < C\) 的样本,代入下面公式中,得到:
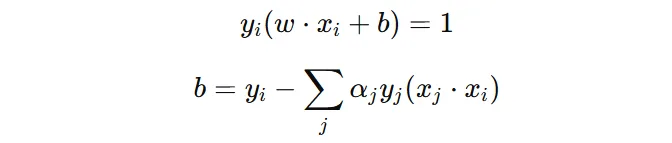
此时,我们就得到支持向量机决策函数。
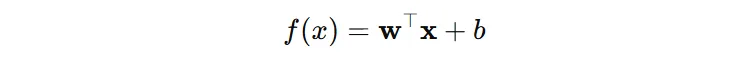
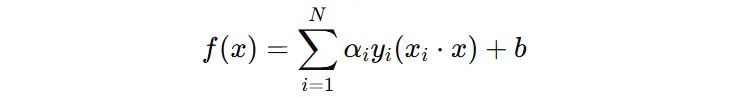
3. 支持向量
\(\alpha_{i} = 0\),根据第二个互补松弛,可得:
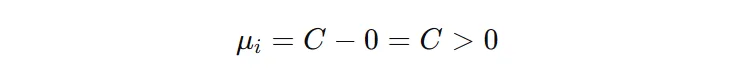
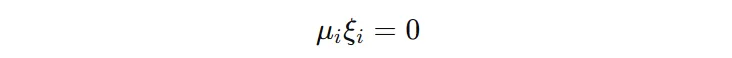
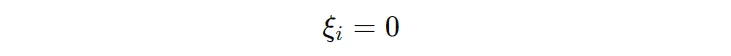
最后,我们得到:
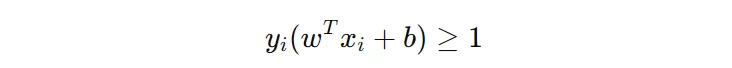
\(\alpha_{i} = C\),根据第一个互补松弛,可以得到
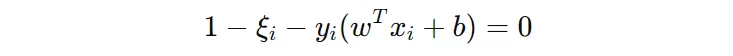
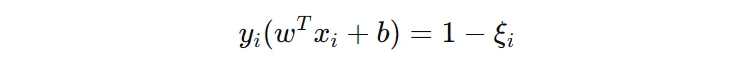
根据第二个互补松弛,可以得到:
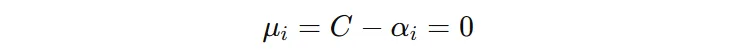
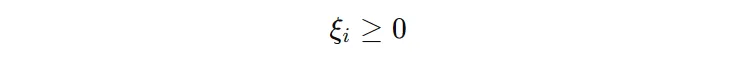
最后,我们得到:
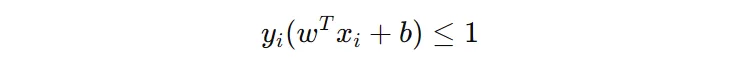
\(0 < \alpha_{i} < C\),根据第一个互补松弛,可以得到:
根据第二个互补松弛,可以得到:
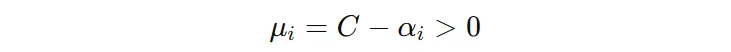
最后,我们得到:
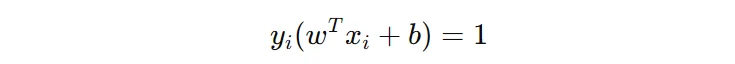
| \(a_i\) | \(ξ_i\) | \(y_i(w·x_i+b)\) | 样本位置 | 是否支持向量 |
|---|---|---|---|---|
| \(a_i=0\) | \(ξ_i=0\) | ≥1 | 间隔外,分类正确 | 否 |
| \(0<a_i<C\) | \(ξ_i=0\) | =1 | 间隔边界上 | 是 |
| \(a_i=C\) | \(ξ_i\ge0\) | ≤1 | 间隔内 / 错分样本 | 是 |
注意:只有 \( \alpha_{i} \gt 0\) 的样本才会对超平面起作用,才是支持向量。